世界模型
思想基础
世界模型(World Models)是人工智能领域一个至关重要的概念,它指的是一个能够对环境或世界的状态进行表征,并预测状态之间转移的模型。20世纪20年代中期,各个领域都开展了相关世界模型的研究工作。
深度学习所提出的深度神经网络模型,如今已经被广泛应用于日常生活中。神经网络模型旨在模拟人脑之间神经元的反应,以模拟人类的智能和智能行为。通过大量的数据集训练,神经网络从中“学习”事物之间的关联,在某些领域成功的模仿甚至说超越了人类的表现。
可以说,深度学习所尝试的东西,本质上是对人脑神经元系统的复刻。另一方面,一些科学家提出了有关人脑不同的理论模式,这也就引出了世界模型的基本思想。
大脑不仅仅是一个根据当下刺激,做出反应的系统,更是一个总结过去,模拟预测未来行动,并关注现实误差的系统。
部分人相信——大脑始终在环境中进行模拟和预测行为。当现实反馈与预测结果有所偏差时,大脑才会关注这些偏差并做出修正反应。因此,人们更倾向于关注变化,而常常忽视稳定不变的事物。
一般定义
计算机视觉、机器人学、强化学习、生成 AI,这几个领域都声称在开发"世界模型",但各自指代的东西截然不同。广义地说,任何能预测接下来会发生什么的模型,都可以被称为世界模型。
- 大语言模型:根据提示词预测下一个词元
- 视频生成模型:把非图像输入转换为动态视频
- 天气预报模型:预测明天的天气
某种意义上,这些模型在训练后学到了世界的部分统计规律:光影如何变化,物体如何运动,场景如何演进。然而,这些模型的输出往往依赖于海量的训练数据,当这些数据有所偏差时,模型的表现往往会放大这些偏差,带来不同于现实世界规律的输出。
与此同时,在机器人学和强化学习(Reinforcement Learning, RL)的语境里,世界模型有更严格的含义:它必须以动作为条件。以 ot 表示 t 时刻的观测结果,at 表示时刻 t 的动作反应,世界模型通常要求预测如下概率分布
p(ot+1∣oτ⩽t,at)
可以发现,前面提到的生成式模型(Generative Model)往往预测的是 p(ot+1∣oτ⩽t)。当我们把对应的动作行为考虑到模型预测中时,所带来的预测结果将更具有真实性和可解释性。
生成式模型
生成式模型是一类通过学习数据的联合概率分布 P(x,y) 来生成数据的机器学习模型。它不仅可以用于分类任务,还能生成新数据样本。生成式模型在监督学习和无监督学习中都有广泛应用。
假设我们想要得到一个生成式模型,用于生成猫的图片。真实世界中猫的图片千姿百态,它们的颜色、姿势、背景、光照等等构成了极其复杂的数据分布。生成式模型的任务就是学习这个分布,然后从中采样(Sampling)出新的、看起来像猫的图片。
世界模型和生成式模型都可以采样出新内容,本篇将围绕以下生成式模型进行简要介绍
- 自回归模型
- 生成式对抗网络GAN
- 变分自编码机VAE
自回归生成
我们曾经在RNN篇中介绍过:一个序列 x={x1,x2,⋯,xT} 的建模问题通常被分解为如下条件概率乘积
p(x)=p(x1)⋅p(x2∣x1)⋯p(xT∣x1,⋯,xT−1)
采用 N 元语法,循环神经网络或注意力机制等可以有效对上述条件概率乘积建模。不难发现,自回归模型通过学习过往序列的数据以训练,其生成过程完全基于自身已有序列数据。
对于自然语言来说,自回归生成序列的顺序可以是从左到右、从右到左,甚至是随机顺序;对于图片来说,可以是扫描序、蛇形曲线、Z 字型曲线、随机序等等。
- 自回归模型是目前 NLP 领域最先进、最成功的范式。
GAN
模型架构
生成式对抗网络(Generative Adversarial Network, GAN)启发自博弈论中的二人零和博弈,由 Ian Goodfellow 于2014年提出。它通过让两个神经网络相互对抗、相互学习,最终能够生成非常逼真的数据。GAN 广泛应用于图像生成、风格迁移、数据增强等场景,其主要由两部分主成
- 生成模型 G (Generative Model):捕捉样本数据的分布并生成新数据。
- 判别模型 D (Discriminative Model):这是一个二分类器,判别输入是真实数据还是生成的样本。
为方便讲解,下图展示了GAN的基本架构。
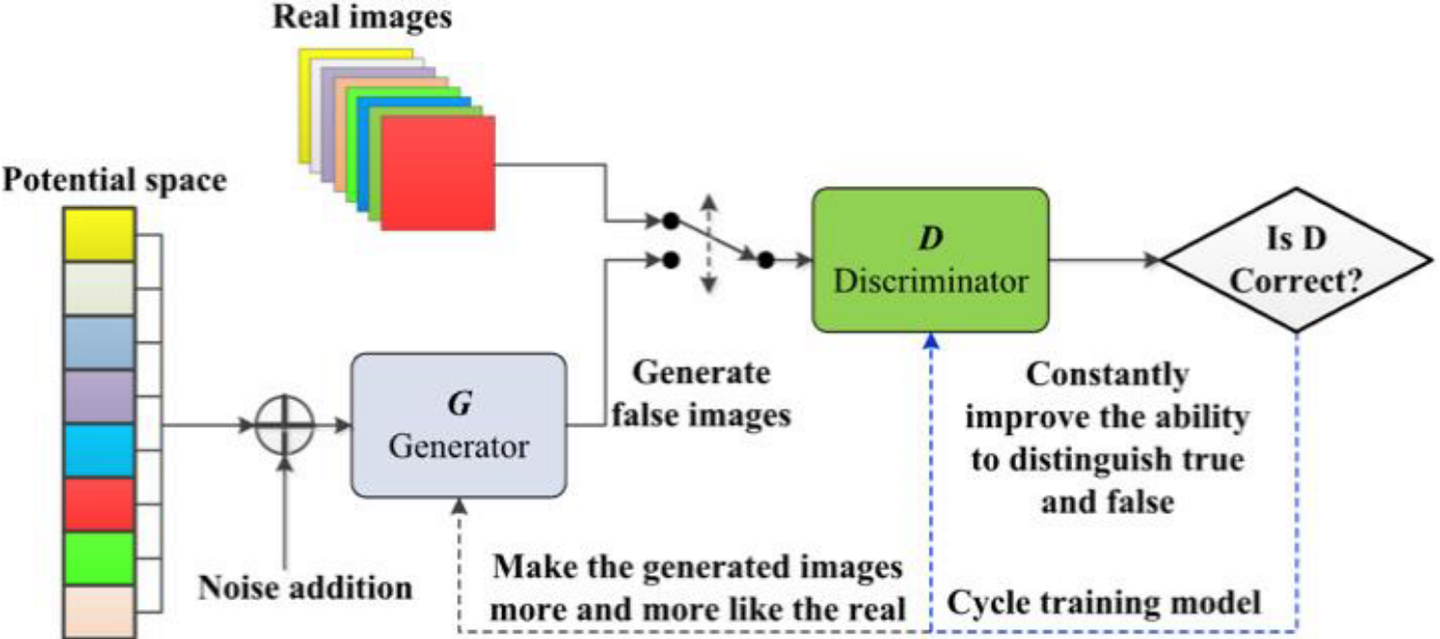
设已知数据空间的样本为 x,其分布表示为 p(x)。GAN引入噪声变量 z,其分布为 pz(z)。生成器 G 和判别器 D 可以看做两个多层感知机,他们对应的映射函数分别起到以下作用
- G 将噪声 z 映射到数据空间
- 输入:噪声 z∼pz(z),通常是高斯噪声
- 输出:伪造样本 G(z;θg) 以拟合真实数据分布
- D 接受一个样本 x,输出其来自真实数据分布 p(x) 的概率
- 输入:任意样本 x
- 输出:标量概率 D(x;θd)∈[0,1]
对抗博弈
从博弈论的视角,GAN的训练目标可以分为两个层面
- 判别器 D:最大化区分真实样本和生成样本的能力。也就是说,使得其对真实样本的输出概率接近 1,对于生成样本的输出概率接近 0。
- 生成器 G:最小化判别器 D 正确区分样本的概率,也就是尽可能的让 D(G(z;θg)) 接近 1,以达到欺骗 D 的目的。
上述思想可以理解为:当判别器 D 已经足够优秀以区分样本时,我们尝试让生成器 G 生成可以欺骗过 D 的样本,此时的生成样本就和原数据一样足够令人可信。基于原文,GAN的价值函数 V(G,D) 定义为
GminDmaxV(G,D)=Ex∼p(x)[logD(x)]+Ez∼pz(z)[log(1−D(G(z)))]
这是一个二元博弈过程,我们可以分析其最优状态。对于固定的生成器 G,我们需要最大化 V(G,D),这就需要找到最优判别器 DG∗。通过积分的形式表示期望为
V(G,D)=∫xp(x)logD(x)dx+∫zpz(z)log(1−D(G(z)))dz
假设生成样本的分布为 pg,进一步简化上式为关于任意样本变量 x 的积分
V(G,D)=∫x[p(x)logD(x)+pg(x)log(1−D(x))]dx
由于函数 f(y)=alogy+blog(1−y) 在 [0,1] 上的最大值为 a+ba,代入上式可以得到
DG∗(x)=p(x)+pg(x)p(x)
现在考虑调整 G,定义如下函数
C(G)=DmaxV(G,D)=Ex∼p(x)[logDG∗(x)]+Ez∼pz(z)[log(1−DG∗(G(z)))]=Ex∼p(x)[logp(x)+pg(x)p(x)]+Ex∼pg(x)[logp(x)+pg(x)pg(x)]
因此优化目标转化为了 GmaxC(G)。可以证明当且仅当 pg(x)=p(x) 时,C(G) 达到全局最小值 −log4。因此 GAN 的收敛目标是使得 pg(x) 收敛于 p(x),这与我们生成新数据的想法一致。
上式严格被描述为 JS 散度优化,此时对于任意样本 x 都有 DG∗(x)=0.5。
梯度优化
GAN采用了SGD方法,通过固定 G,D 二者之一并训练余者达到收敛目的。对于某一个小批量的真实样本 {xi∼p(x)}i=1m 和噪音样本 {zi∼pz(z)}i=1m,梯度按照下述情况更新
(+)∇θdm1i=1∑m[logD(xi)+log(1−D(G(zi)))],θg stays still
(−)∇θgm1i=1∑mlog(1−D(G(zi))),θd stays still
VAE
KL散度
变分自编码器(Variational Auto-Encoders,VAE)是由 Kingma 等人于 2014 年提出的基于变分贝叶斯(Variational Bayes,VB)推断的生成式网络结构。与GAN类似,二者属于无监督学习领域非常具有研究价值的模型架构。
以序列生成为例,传统的编码器解码器架构通常被描述为:将给定输入 X 编码为中间变量 Z,再将其解码为输出 Y。从这可以看出,常见编码器解码器架构和GAN等生成模型的思路基本一致——目标是构建一个隐变量 Z,其服从某些常见分布,并训练模型 Y=f(Z) 生成新数据。
显然,采样数据 Y 的分布 p(Y) 可以通过 Z 的分布和模型 f 得到。倘若我们得到了 p(X) 的表达式,那么可以通过 KL 散度衡量 p(X) 与 p(Y) 的相似度,毕竟我们希望生成的 Y 具有和 X 类似的性质和分布。
KL 散度又称相对熵,以两个连续概率分布 P,Q 为例,设其概率密度函数为 p(x),q(x),则有
DKL(P∥Q)=∫xp(x)logq(x)p(x)dx=Ex∼P[logq(x)p(x)]⩾0
显然,KL 散度不具有对称性。当且仅当 P=Q,其 KL 散度为零。
通常情况下,我们无法直接获取数据集数据 X={xi}i=1n 的分布 px。在 GAN 中同样有这样的问题,而作者们直接提出了判别器 D 作为度量,其作为神经网络接受数据并训练,这相对于公式化的度量(如 MSE 损失,KL 散度)而言更具有可塑性。
编码器解码器
回过头来,如果我们坚持使用公式度量的话,VAE给出一种全新的思路。我们的目标是通过已有离散数据 {x(1),⋯,x(n)} 拟合出整体 X 的概率分布(假设这些样本独立同分布),但直接获得这个 p(x) 是很难的,因此考虑条件概率公式
p(x)=z∑p(x∣z)p(z)
其中,我们通常假设隐变量 Z∼N(0,I),这将有助于我们使用神经网络构建合适的变换 f。尽管如此,上式中的 p(x∣z) 仍然较难得到,因此我们考虑引入变分下界(Evidence Lower BOund, ELBO)以近似拟合。
在正式介绍变分下界之前,我们必须了解其近似原理。若隐变量 Z 是连续的,那么就需要对所有的 z 积分,其中的部分 z 对于 p(x) 的贡献是微乎其微的,因此舍弃这些 z 将不会对 p(x) 带来较大的影响。
为了知道哪些 z 对 p(x) 的影响较大,我们可以计算后验概率 p(z∣x)。在计算后验概率时,我们可以使用已知数据集 {x(1),⋯,x(n)} 代入计算,得到贡献较大的 z。然后,我们使用这些 z 去训练模型,就可以近似得到一个数据的概率分布 p(x)。
注意到,上述过程中的 p(x∣z) 和 p(z∣x) 可以用编码器解码器架构求解。
- 后验分布 p(z∣x):对应编码器,把输入编码为隐变量 z
- 先验分布 p(x∣z):对应解码器,把隐变量解码为新数据 x
变分下界
想要得到精确的先验分布和后验分布几乎是不可能的,因此我们采用变分下界近似拟合。先讨论后验分布的近似,目标是建模 q(z∣x) 作为近似后验分布,那么只需要采样 z∼q,并通过 KL 散度得到相似度。
DKL[q(z∣x)∥p(z∣x)]=Ez∼q[logp(z∣x)q(z∣x)]
利用对数函数的性质和贝叶斯公式,将上式右端展开为
DKL[q(z∣x)∥p(z∣x)]=Ez∼q[logq(z∣x)−logp(z∣x)]=Ez∼q[logq(z∣x)−logp(x)p(x∣z)p(z)]=Ez∼q[logq(z∣x)−logp(x∣z)−logp(z)+logp(x)]=Ez∼q[logq(z∣x)−logp(x∣z)−logp(z)]+logp(x)
将上式移项并整理,可以得到
logp(x)−DKL[q(z∣x)∥p(z∣x)]=Ez∼q[logp(x∣z)]−DKL[q(z∣x)∥p(z)]
由于 KL 散度具有非负性,因此上式给出了 logp(x) 的一个下界
logp(x)⩾Ez∼q[logp(x∣z)]−DKL[q(z∣x)∥p(z)]=defELBO
注意到,我们的最终目标是最大化 p(x),而上式给出了 logp(x) 的一个下界 ELBO。因此我们优化的目标转化为最大化 ELBO,这与分支限界法具有异曲同工之处。
上式中的 p(x∣z) 同样较难得到,方便起见,我们重新叙述部分符号表示。
- qϕ(z∣x):用于近似表示 q(z∣x),其参数为 ϕ
- pθ(x∣z):用于近似表示 p(x∣z),其参数为 θ
此时可以将 ELBO 重新整理为如下形式
ELBO=Eqϕ(z∣x)[logpθ(x∣z)]−DKL[qϕ(z∣x)∥p(z)]
此变分下界含有两项,我们可以直观理解为
- Eqϕ(z∣x)[logpθ(x∣z)]:这一项关乎解码器。当我们将隐变量 z 传入解码器时,我们希望最大化 logpθ(x∣z) 以获得一个理想的输出 x。取决定性作用的是参数 θ
- −DKL[qϕ(z∣x)∥p(z)]:这一项关乎编码器。我们希望通过 KL 散度作为度量,尽可能缩小 qϕ(z∣x) 与隐变量分布 p(z) 的区别。取决定性作用的是参数 ϕ
重参数化
由于真实的概率分布无从得知,我们的优化目标变为
(ϕ,θ)=argϕ,θmaxELBO
其中考虑的参数 x(i),i=1,⋯,n 来自已有数据集。考虑该下界对参数 ϕ,θ 的梯度,可以证明 ∇ϕ,θELBO 无法通过梯度的反向传播进行更新,因此我们需要引入一些优化技巧。
前面所提到的 z 均由 qϕ(z∣x) 采样而来,因此参数梯度是不可反向传播的。引入服从某固定分布(如标准高斯分布)的噪声项 ϵ ,我们可以将 z 的产生封装为一个可微且可逆的函数 g,写作
z=gϕ(x,ϵ)∼qϕ(z∣x),ϵ∼p(ϵ)
由概率论知识可知,对于随机噪声变量 ϵ∼p(ϵ),g 的存在要求下式成立
p(ϵ)dϵ=qϕ(z∣x)dz
此时可以利用蒙特卡洛法求出梯度。对于某函数 f(z),其期望被拆分为
Eqϕ(z∣x(i))[f(z)]=Eϵ∼p(ϵ)[f(gϕ(x(i),ϵ))]≈L1l=1∑Lf(gϕ(x(i),ϵ(l)))
其中 ϵ(l)∼p(ϵ),把这一结果应用于变分下界,就可以借助噪音 ϵ 的采样得到近似梯度。为表示简便,使用 L(ϕ,θ;x(i)) 表示对指定样本 x(i) 的变分下界值,则其近似值表示为
L~(ϕ,θ;x(i))=L1l=1∑Llogpθ(x(i)∣z(i,l))−DKL[qϕ(z∣x(i))∥p(z)]
其中 z(i,l)=gϕ(x(i),ϵ(l)),这一结果可以进一步结合小批量样本 X 构造整个数据集的变分下界近似值
L(ϕ,θ)≈L~M=MNi=1∑ML~(ϕ,θ;x(i))
其中 M 为小批量数据 X 随机抽样的样本个数, N 为样本总数。此时通过对 ∇ϕ,θL~M 应用SGD或Adam等梯度优化法,可以实现模型的参数更新。这一算法被称为自编码VB(AEVB)算法。
本节实际上从算法层面证明了,重参数化技巧可以通过蒙特卡洛法优化梯度。如果我们能够显式的计算出输入 X 和生成结果 Y 的距离(比如 L2 范数),那么也可以把这个距离项增加到目标函数 L 中。
变分自编码器
在介绍完变分下界和重参数化技巧后,我们可以设计一个变分自编码器架构。我们设隐变量的先验分布 p(z)∼N(z;0,I),解码器 pθ(x∣z) 服从多元高斯分布(如果数据为实数)或Bernoulli分布(如果数据为二元值),其架构为一个MLP。
现在关注编码器 p(z∣x),其不容易直接得出。我们使用 qϕ(z∣x) 近似代替编码器,并且其简单服从对角协方差的高斯分布。对于输入样本 x(i),变分自编码器被解释为
logqϕ(z∣x(i))∼logN(z;μ(i),(σ2)(i)I)
其中的向量 μ(i),(σ2)(i) 表示编码器MLP的输出,即输入多维数据 x(i) 的均值和标准差。现在需要借助重参数化技巧采样 z。由上节的讨论可知
z(i,l)=gϕ(x(i),ϵ(l))=μ(i)+σ(i)∘ϵ(l)∼qϕ(z∣x(i)),ϵ(l)∼N(ϵ;0,I)
利用AEVB算法和 KL 散度的定义可以求出 logp(x(i)) 的变分下界估计值
L(ϕ,θ;x(i))≈21j=1∑J(1+log(σj(i))2−(μj(i))2−(σj(i))2)+L1l=1∑Llogpθ(x(i)∣z(i,l))
工作流
讲了那么多,为了理清VAE的原理脉络,我们重新叙述一遍其工作流。
VAE由编码器网络 qϕ(z∣x) 和解码器网络 pθ(x∣z) 组成
- 编码器接受输入 x,输出隐变量 z 分布的参数 μ,σ2
- 解码器接受输入 z,输出重建数据的分布参数
编码器输出的不是 z 本身,而是一个高斯分布的参数 μ,σ2。至于我们为什么设定 z 的先验分布为正态分布 N(z;0,I),这是因为 z 只是我们人为设定的一个中间量,而正态分布形式的中间量将简化我们训练编码器 qϕ(z∣x) 和解码器 pθ(x∣z) 的过程。
在训练阶段,数据经过如下步骤处理
- 输入 x 经过编码器 qϕ(z∣x) 得到其均值 μ=μϕ(x) 和方差 σ2=σϕ2(x),这定义了一个高斯分布 N(z;μ,σ2I)
- 不直接从 qϕ(z∣x)=N(z;μ,σ2I) 采样出 z,而是通过重参数化技巧,通过函数 z=gϕ(x,ϵ)=μ+σ∘ϵ 进行采样。这保证了参数梯度可以回传
- 将 z 送入解码器 pθ(x∣z),输出Bernoulli概率(二值数据)或高斯均值和方差(实值数据)
- 计算正向传播的变分下界 L,其由重建项和 KL 散度项组成
- 通过AEVB算法反向传播,执行参数的梯度优化
训练完成后,编码器不再需要,此时进入生成阶段
- 从先验 p(z)=N(z;0,I) 中随机取样 z
- 将 z 经过训练好的解码器 pθ(x∣z),得到输出 x
生成阶段的步骤很简单,这是因为我们已经指定了先验分布 p(z)=N(z;0,I),而变分下界中的 KL 散度项使得编码器 qϕ(z∣x) 学习参数 ϕ 以逼近标准正态分布,同时 θ 也得到学习。当训练足够久后,我们就可以直接从先验分布中采样 z 了。